Izan Vílchez

Madrid, España --:--:--

Izan Vílchez

Estudiante de ASIR en Madrid, enfocado en sistemas, automatización y cloud. Construyo herramientas, juegos y simuladores, y los termino: con tests, documentación y algo que puedes descargar o jugar hoy.

Foto de Izan Vílchez
Ubicación
Madrid, España
Enfoque
Sistemas y DevOps
Estado
Abierto a prácticas

Sobre mí

Me gusta construir cosas que funcionan de verdad y dejar claro cómo están hechas.

Estudio el CFGS de Administración de Sistemas Informáticos en Red (ASIR) en Madrid. Me interesan los sistemas, la automatización y el cloud, y aprendo construyendo: cada proyecto es una excusa para meterme en algo nuevo, desde el versionado de datos hasta la simulación de un centro de datos.

Mi regla es la transparencia: cada cambio documentado, cada proyecto con una guía clara y tests que lo respaldan. Se me da bien trabajar con IA y la uso a diario: mis aplicaciones las he hecho con su ayuda, y yo me encargo de dirigirla, revisar lo que genera y probarlo. Prefiero un proyecto pequeño y terminado a uno grande a medias.

Busco prácticas y primeras oportunidades en sistemas o DevOps, y quiero seguir contribuyendo al código abierto. Si tienes una oportunidad o una idea, hablamos.

Formación

Estoy en primer curso del CFGS de Administración de Sistemas Informáticos en Red (ASIR) en Madrid. Esto es lo que trabajo en el ciclo y lo que he aprendido por mi cuenta.

Fundamentos de hardware

Hardware

  • Montaje y configuración de equipos
  • Diagnóstico y reparación de averías
  • Clonación de discos e imágenes de sistema
  • Hardware de un centro de datos (CPD)

Implantación de sistemas operativos

Sistemas operativos

  • Instalación de Windows y Linux
  • Particiones, sistemas de ficheros y arranque
  • Usuarios, grupos y permisos
  • Virtualización y scripts de automatización

Planificación y administración de redes

Redes

  • Modelo OSI y TCP/IP
  • Direccionamiento IPv4 e IPv6 y subnetting
  • Switches, VLAN y enrutamiento
  • Cableado estructurado y redes inalámbricas

Gestión de bases de datos

Bases de datos

  • Modelo entidad-relación y normalización
  • SQL: creación, consultas y modificación
  • Vistas, índices y restricciones
  • MySQL y MariaDB

Lenguajes de marcas

Lenguajes de marcas

  • HTML y CSS
  • XML, DTD y XML Schema
  • XPath y XQuery
  • JSON y sindicación de contenidos

Aprendido en mis proyectos

Por mi cuenta

  • Docker y contenedores
  • GitHub Actions: CI y releases automáticas
  • Git y flujo con pull requests
  • Linux como sistema de uso diario

Proyectos

Cinco proyectos propios, todos con su código en GitHub.

Publicado en PyPI

DataSemver

github.com/IzanVil/datasemver

Tus datos cambiaron. DataSemver te dice si es un patch, un minor o un breaking.

El código tiene versionado semántico y los datos no. DataSemver compara dos versiones de un dataset en CSV, JSON o Parquet, clasifica cada diferencia con reglas configurables en YAML y devuelve el salto de versión junto con una entrada de changelog lista para commitear. Es una CLI primero y una librería de Python después, sin registro de esquemas, sin base de datos y sin servicios corriendo.
  • Probado en Linux, macOS y Windows
  • Python 3.10 a 3.14
  • GitHub Action y panel web incluidos
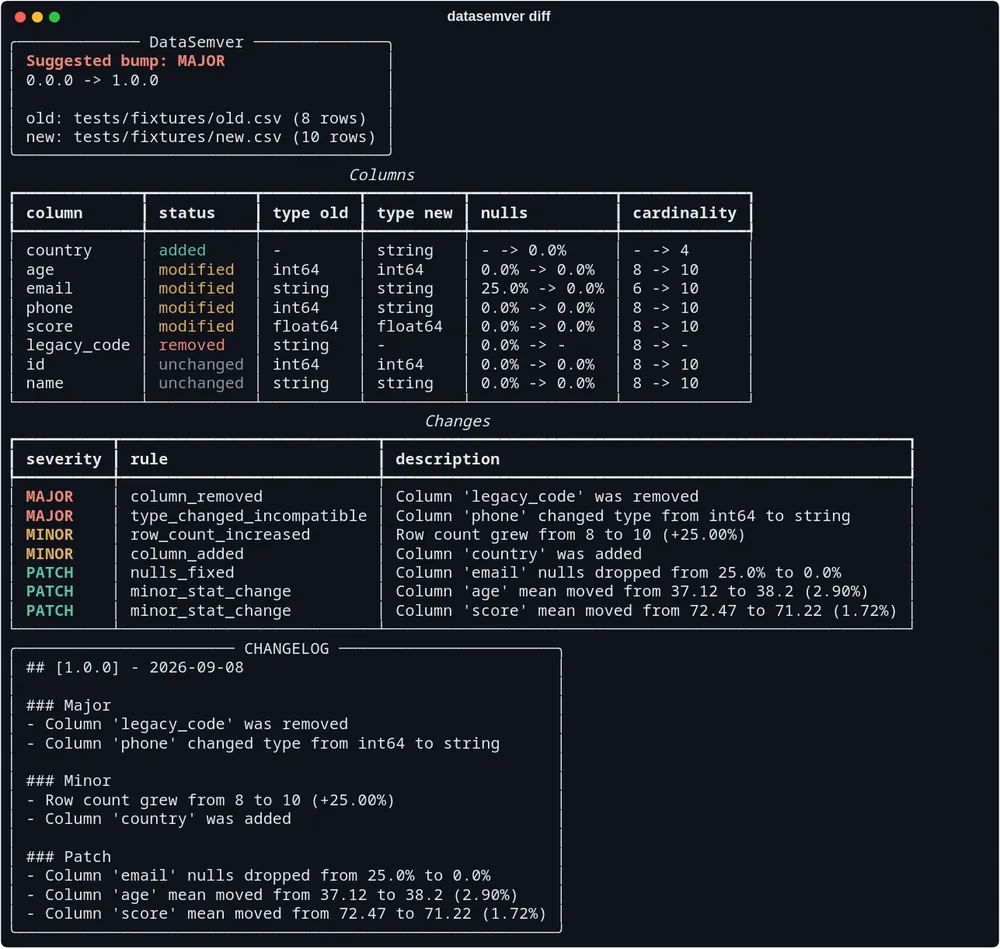
Terminal con datasemver diff: salto MAJOR de 0.0.0 a 1.0.0, tabla de columnas y la entrada de changelog generada.
Una columna eliminada y un entero que pasa a texto: release rompedora.
Publicado en PyPI, en alfa (0.2.4)

RippleRack

github.com/IzanVil/RippleRack

Ve la onda expansiva antes de hacer el cambio.

Un simulador local de centros de datos y pipelines de datos. Describes racks, servidores, servicios y pipelines en un único YAML y RippleRack te dice qué pasa cuando algo cambia: compara dos versiones de un esquema y calcula si es un patch, un minor o un major, recorre el grafo de dependencias para encontrar qué consumidores se rompen aguas abajo, importa un JSON Schema o un esquema Avro y simula qué se sobrecarga cuando sube la carga o cae un servidor. Todo corre en local desde un fichero de texto, sin agentes, sin cuentas en la nube y sin bases de datos.
  • 1.954 tests y CI en GitHub Actions
  • Python 3.11 a 3.14, licencia MIT
  • Sale con código 2 si se rompe un consumidor, para frenar una PR en CI
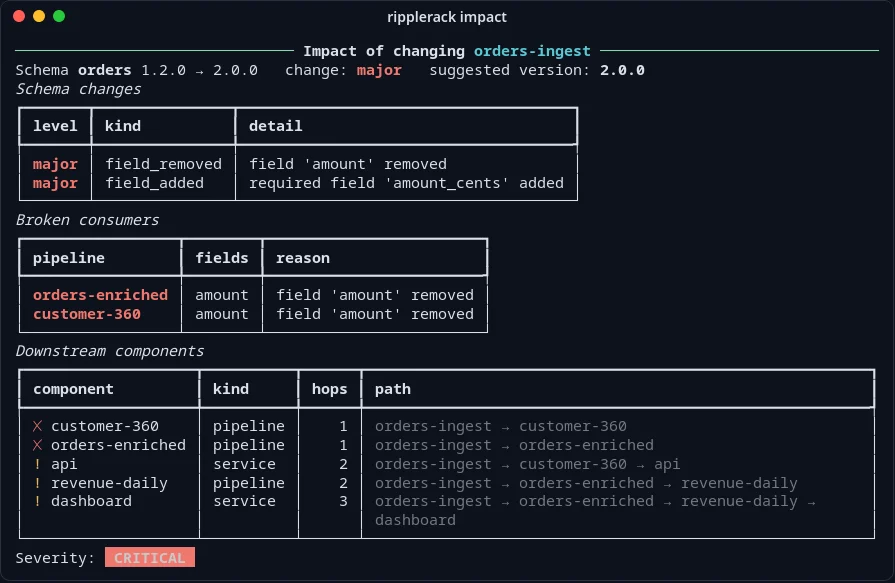
Terminal con ripplerack impact: al renombrar un campo se rompen dos pipelines consumidores, se ven los componentes aguas abajo en riesgo y la severidad es crítica.
Renombrar un campo rompe dos pipelines y deja tres componentes en riesgo.
En producción, jugable en el navegador

UPTIME Turno de Noche

github.com/IzanVil/rack-and-ruin

Un rack. Un técnico. Toda la noche.

Un simulador de mantenimiento de un centro de datos en tiempo real, hecho en Unity 6. El balanceador reparte el tráfico entre los servidores en línea, y cada turno entra más que el anterior. Calor, fugas de memoria, deuda de parches y desgaste se rompen a la vez, y arreglar un servidor obliga a sacarlo del balanceador justo cuando más falta hace. Hay turno del día, partida guardada y récords por modalidad, y se juega igual en el móvil.
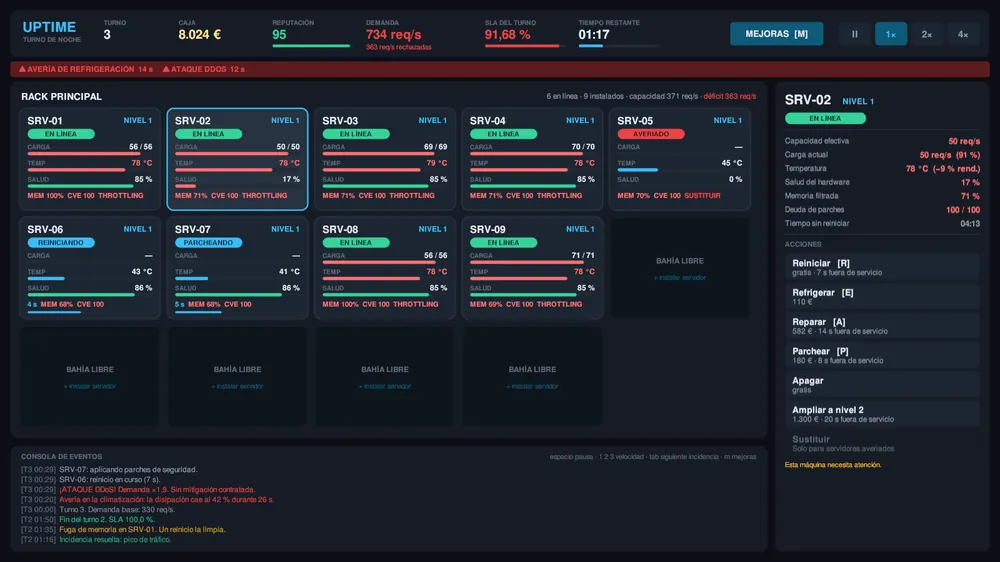
  • 7.283 líneas de C#
  • 0 assets binarios: todo se genera por código
  • 0 fallos en la prueba de humo
El rack de UPTIME bajo presión durante el turno 3: un DDoS y una avería de climatización a la vez, con seis máquinas en throttling.
Turno 3. Un DDoS y una avería de climatización a la vez.
En alfa, ya se usa a diario

Mosaic

github.com/IzanVil/mosaic

Todos tus proyectos de código, en un solo tablero.

Una app de escritorio que encuentra sola todos tus proyectos en el disco y los muestra en un tablero con el estado de Git en vivo: rama, cambios sin commitear y commits por delante y por detrás. Los etiquetas con colores, los filtras con búsqueda difusa y abres cada uno en tu editor o tu terminal con un clic. Es local y privada: sin cuentas, sin telemetría, sin IA y sin una sola petición de red.
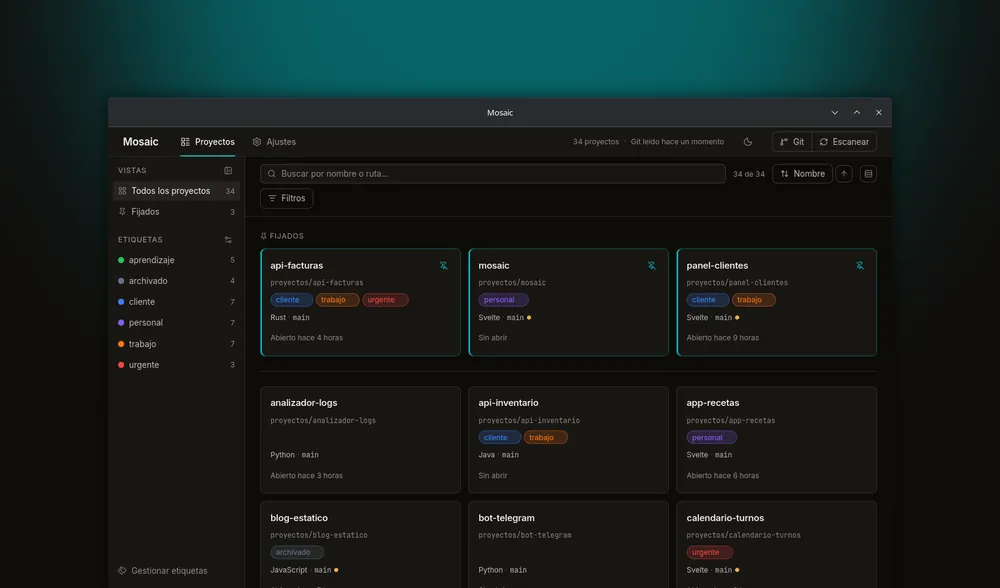
  • Hecha con Rust, Svelte 5 y TypeScript sobre Tauri 2
  • Todo vive en un SQLite local, nunca escribe en tus repos
  • Versión 0.2.1 publicada para macOS, Windows y Linux
El tablero de Mosaic: tres proyectos fijados arriba y el resto en rejilla, cada tarjeta con su ruta, sus etiquetas de color, su lenguaje y su rama de Git.
El tablero: proyectos fijados arriba y el resto en rejilla.
En desarrollo, con builds para Linux y Windows en CI

El Tambor del Juicio

github.com/IzanVil/last-click-game

¿Te sientes con suerte? El tambor gira y la bala te está esperando.

Un juego de deducción y riesgo en dos versiones que comparten la misma mecánica: un clásico de terminal en Python con colores ANSI y un tambor que gira, y una versión gráfica 2D en Godot con banda sonora de dos capas que se acelera según se vacía el tambor. Ocho huecos, una bala que se desplaza siguiendo un patrón oculto y pistas que a veces mienten. La versión gráfica añade un reto del día: un tambor igual para todos.
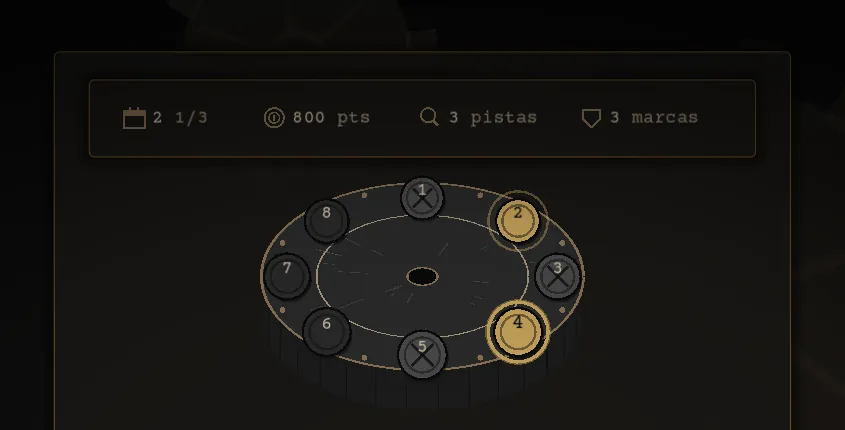
  • 99 % de cobertura de tests
  • Ejecutables que no necesitan ni Python ni Godot
  • Builds automáticas en CI con cada versión
La versión gráfica del Tambor del Juicio: barra de estado con día, puntos, pistas y marcas, y el tambor de metal en escorzo.
La versión gráfica, hecha en Godot.

Contribuciones notorias

Código mío que ya forma parte de proyectos de otros.

Fusionado el 29 de septiembre de 2026

Azure Linux de Microsoft

github.com/microsoft/azurelinux/pull/18982

Mi primera contribución fusionada en un proyecto de Microsoft.

Azure Linux es la distribución Linux de Microsoft para Azure. En las instrucciones de su pipeline de CI había tres enlaces que usaban rutas desde la raíz del repositorio, pero GitHub los resolvía desde la carpeta del propio archivo, así que daban 404. Los reescribí como rutas relativas, igual que el resto de enlaces del archivo, y comprobé que la regeneración automática de la documentación no los volvía a romper. El equipo de Azure Linux lo revisó y lo fusionó.
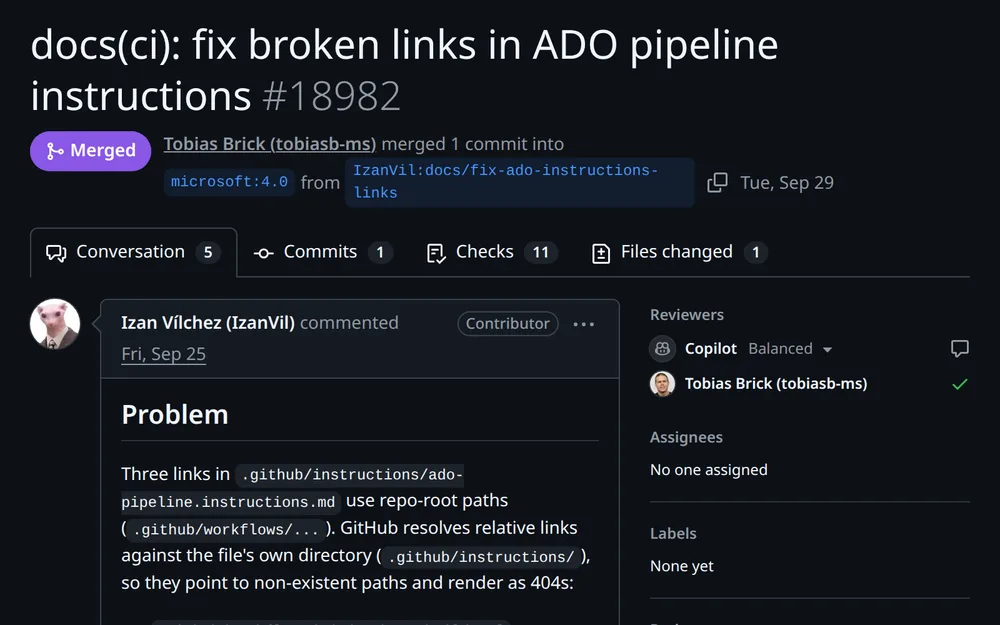
  • Repositorio con más de 5.300 estrellas
  • 3 enlaces rotos arreglados
  • Revisado y fusionado por el equipo de Azure Linux
Captura de la pull request #18982 de Azure Linux en GitHub: título «docs(ci): fix broken links in ADO pipeline instructions», etiqueta Merged, fusionada el 29 de septiembre, y el principio de mi descripción del problema.
La pull request tal como se ve en GitHub.
Fusionado el 23 de octubre de 2026

Azure Linux Dev Tools de Microsoft

github.com/microsoft/azure-linux-dev-tools/pull/392

Mi segunda contribución fusionada en un proyecto de Microsoft.

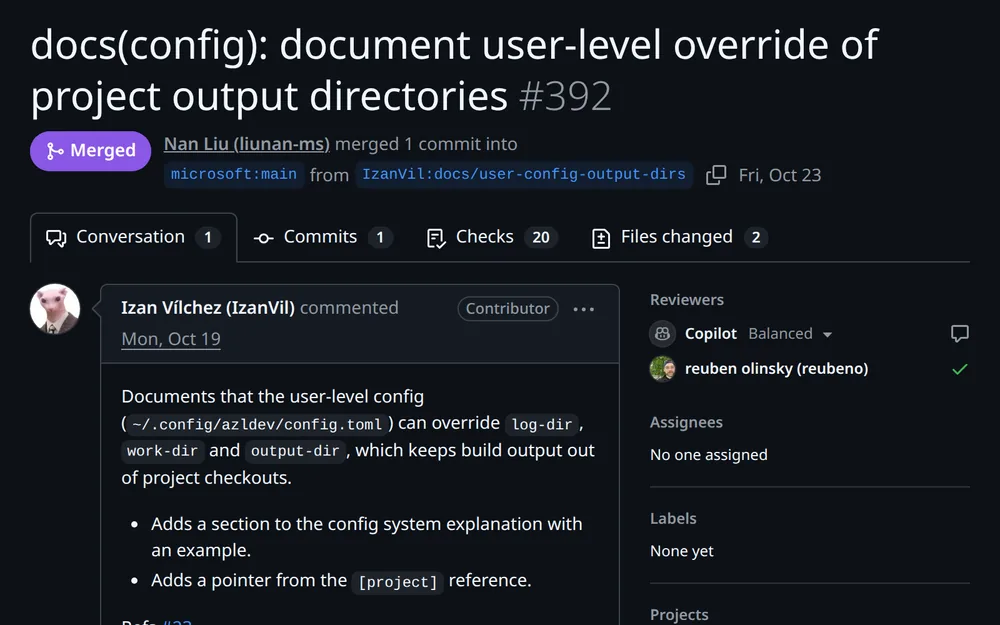
azldev es la herramienta de línea de comandos de Microsoft para construir y mantener Azure Linux. Había una petición abierta para sacar los logs y los ficheros de compilación del directorio de cada proyecto. Esa opción ya existía, pero nadie la había documentado: se puede hacer desde la configuración de usuario. Escribí la sección que lo explica, con un ejemplo, y un aviso en la referencia del proyecto, y el equipo la aprobó y la fusionó.
  • Documentación en 2 archivos, con un ejemplo de configuración
  • Responde a la petición #23 del proyecto
  • Aprobado y fusionado por el equipo de Azure Linux
Captura de la pull request #392 de Azure Linux Dev Tools en GitHub: título «docs(config): document user-level override of project output directories», etiqueta Merged, fusionada el 23 de octubre, y el principio de mi descripción.
La pull request tal como se ve en GitHub.
Fusionado el 27 de octubre de 2026

Azure Linux 4.0 de Microsoft

github.com/microsoft/azurelinux/pull/18984

Mi tercera contribución fusionada en un proyecto de Microsoft.

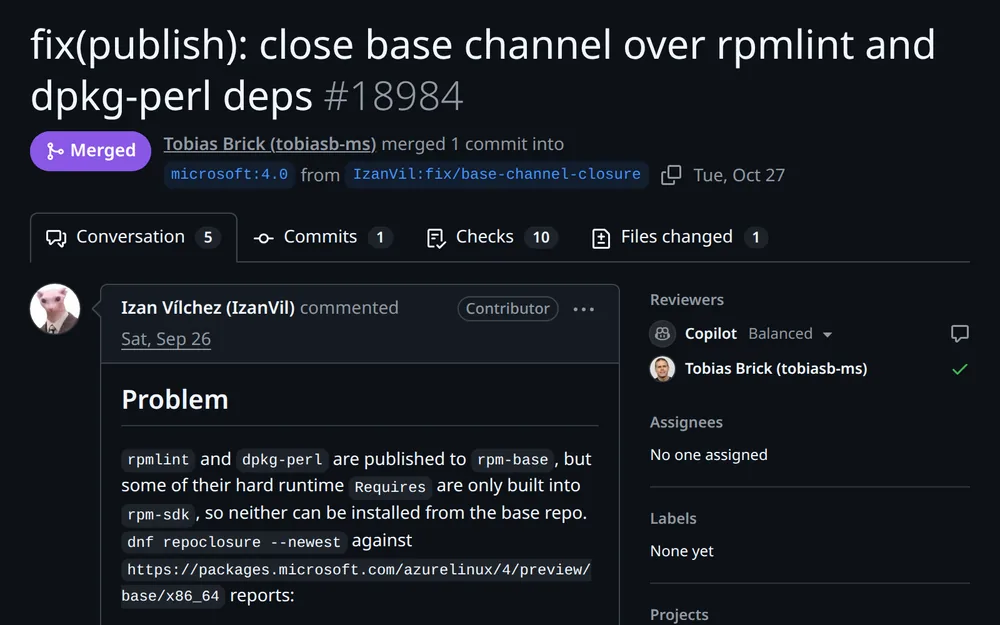
En Azure Linux 4.0, los paquetes rpmlint y dpkg-perl se publicaban en el repositorio base, pero algunas de sus dependencias de ejecución solo estaban en el del SDK, así que no se podían instalar solo con el base. Lo detecté con dnf repoclosure, que listaba cuatro dependencias sin resolver, y moví a base los cinco componentes que las proporcionan. El paquete devscripts es grande, así que dejé el principal en el SDK y llevé solo el subpaquete pequeño que hacía falta.
  • 5 componentes movidos al repositorio base
  • Comprobado con dnf repoclosure y azldev antes de enviarlo
  • Fusionado por el equipo de Azure Linux
Captura de la pull request #18984 de Azure Linux en GitHub: título «fix(publish): close base channel over rpmlint and dpkg-perl deps», etiqueta Merged, fusionada el 27 de octubre, y el principio de mi descripción del problema.
La pull request tal como se ve en GitHub.

Colaboración en la PR #18411 de Azure Linux. Detecté que los enlaces a las definiciones de imagen ya no existían y propuse una alternativa con comprobaciones; la autora reconoció que mi análisis ayudó a corregirla. Ver la conversación

Herramientas

Con lo que trabajo. Pasa el ratón o toca un puerto para conectarlo.

Lenguajes
Motores
Datos
Plataforma
IA
Diseño

¿Hablamos?

Nuevas oportunidades, colaboraciones o simplemente intercambiar ideas. Respondo a todo.

Caso de estudio: UPTIME

El problema

Un juego que se comparte con un enlace vive o muere en la primera carga: es el tiempo que alguien mira una barra de progreso antes de decidir si le interesa. Y tenía que jugarse igual de bien en un móvil que en un escritorio.

Cómo funciona

  1. Código C#7.283 líneas. La interfaz y el sonido se generan por código, sin un solo asset binario.
  2. Build WebGLSolo 6 de los 32 módulos de Unity y el podado de código al máximo.
  3. Prueba de humoComprueba, entre otras cosas, que la interfaz responde al ratón y al dedo.
  4. Rama gh-pagesSe publica en una rama huérfana que se reescribe entera, y su commit lleva el SHA del código del que salió.
  5. GitHub PagesLos ficheros llevan el hash del contenido en el nombre, así que nadie se queda con una versión vieja en caché.

Decisiones técnicas

  • La build no se versiona en main, para que el repositorio no acumule unos 5 MB de binarios por versión.
  • Tres disposiciones (escritorio, móvil en vertical y móvil tumbado) elegidas por el tamaño en píxeles CSS y no por Screen.width, que en una pantalla 3x daría más de 1.100.
  • Si cambias de pestaña la partida se pausa sola, y si cierras la pestaña te espera.

Resultados

  • La primera carga pasó de 7,3 MB a 5,4 MB, un 26 % menos, sin tocar una línea de lógica.
  • El fichero .wasm bajó de 5,64 MB a 4,02 MB.
  • Se juega en cualquier móvil, desde 320 px de ancho.

Caso de estudio: DataSemver

El problema

El código tiene versionado semántico y los datos no. Una columna eliminada o un teléfono que pasa de número a texto rompen a quien consume el dataset, y suelen publicarse como «dataset actualizado».

Cómo funciona

  1. Dos versionesCSV, JSON, Parquet, Excel o una tabla SQL.
  2. PerfilTipos, nulos, cardinalidad y cuantiles de cada columna: son agregados, así que no hace falta cargar las filas.
  3. Reglas en YAMLCada diferencia se clasifica como patch, minor o major con reglas configurables.
  4. Salto de versiónLa versión nueva sugerida y una entrada de changelog lista para commitear.
  5. Pull requestLa GitHub Action comenta el resultado en cada PR y puede bloquear el merge si el cambio rompe algo.

Decisiones técnicas

  • CLI primero y librería después: sin registro de esquemas, sin base de datos y sin servicios corriendo.
  • El motor nunca se elige solo: cambiarlo porque un fichero parece grande respondería a una pregunta que nadie ha hecho.
  • Cada fichero declara su codificación, para que el cp1252 por defecto de Windows no decida nada. Se prueba con rutas con espacios, acentos y caracteres fuera de Latin-1.
  • Un ejecutable por plataforma que trae su propio Python, compilado en cuatro runners porque PyInstaller no compila de forma cruzada.

Resultados

  • Con 16 millones de filas en Parquet, el motor duckdb-sketch tarda 3,1 s frente a 21,4 s del motor por defecto, con 1.246 MB de memoria frente a 3.190 MB.
  • Probado en Linux, macOS y Windows con Python 3.10 a 3.14.
  • Publicado en PyPI (versión 0.8.2) y como GitHub Action.

Caso de estudio: RippleRack

El problema

En una empresa los datos viven en un grafo: un topic de Kafka alimenta un job de Spark, que alimenta un dashboard. Renombrar una columna rompe todo lo que hay aguas abajo y nadie se entera hasta que salta una alerta de madrugada. Las herramientas miran las máquinas, las tablas o la compatibilidad de esquemas por separado, y ninguna lo junta.

Cómo funciona

  1. Un YAMLRacks, servidores, servicios y pipelines en un solo fichero. Se valida antes de usarlo: referencias, ids únicos, ciclos y claves mal escritas.
  2. GrafoEl fichero se convierte en un grafo dirigido y el radio de impacto de un componente es todo lo que se alcanza desde él.
  3. Reglas SemVerCompara dos esquemas y da un nivel de patch, minor o major a cada cambio, además de si rompe a quien lo lee. Nunca mira los datos.
  4. ImpactoQué consumidores directos se rompen y qué queda en riesgo aguas abajo, con una severidad de ninguna a crítica.
  5. Salida y CITabla, JSON versionado o diagrama Mermaid. Con --fail-on-breaking sale con código 2 si algo se rompe, para frenar una PR.

Decisiones técnicas

  • El cambio se juzga desde el lado de quien lee: pasar un campo de obligatorio a opcional es major, porque un lector no tiene código para un nulo que antes no existía, y el camino inverso es minor. Es una decisión documentada, no un descuido.
  • Un renombrado es un borrado más un alta, así que es major. Nunca se adivina: solo se avisa de un posible renombrado, y la severidad no se subestima en silencio.
  • El impacto se evalúa sobre el datacenter nuevo: un consumidor adaptado en el mismo cambio no se marca como roto, y ante la duda se informa del fallo.
  • Los importadores de JSON Schema y Avro son estrictos por defecto: lo que decide qué campos existen y no tiene equivalente es un error que dice dónde. Con --lenient pasa a un campo json y un aviso.

Resultados

  • Renombrar amount a amount_cents en el ejemplo rompe 2 pipelines, deja 3 componentes en riesgo y da severidad crítica.
  • 1.954 tests, con pruebas basadas en propiedades (Hypothesis) y ficheros de referencia. Otros tests comprueban que la documentación y las capturas del README siguen siendo ciertas.
  • CI en GitHub Actions con Python 3.11 a 3.14. Publicado en PyPI (versión 0.2.4, en alfa) con licencia MIT.

Caso de estudio: Mosaic

El problema

Cuarenta carpetas en ~/proyectos, la mitad con cambios sin commitear que ya no recuerdas, y para abrir la que buscas toca cd, ls y adivinar. Mosaic te da la vista de pájaro, sin salir de tu máquina.

Cómo funciona

  1. EscaneoRecorre la carpeta que le das y detecta cada proyecto por su .git, package.json, Cargo.toml… sin seguir enlaces simbólicos, así que los ciclos no le afectan.
  2. LenguajeLo deduce del manifiesto o, si no basta, contando extensiones. Los empates se rompen por orden alfabético para que el resultado sea siempre el mismo.
  3. GitRama, cambios sin commitear y commits por delante y por detrás, leídos en segundo plano a los 5 segundos de arrancar y cada 5 minutos.
  4. SQLite localTodo vive en un fichero en tu máquina. Mosaic lee tus repositorios y nunca escribe en ellos.
  5. TableroSvelte pinta las tarjetas: búsqueda difusa, etiquetas de color y una paleta con Ctrl+K para saltar a cualquier proyecto.

Decisiones técnicas

  • Rust hace todo el trabajo con el disco y la base de datos, y el frontend solo pinta. Los comandos no llevan lógica, el núcleo no conoce Tauri y todo el SQL está en un solo módulo.
  • La librería de Git se compila sin soporte de red (ni ssh ni https), así que Mosaic no puede hacer una petición aunque quisiera. Los commits por delante y por detrás se calculan sin hacer fetch.
  • Un solo escritor sobre SQLite con un Mutex en lugar de un pool: un pool sería complejidad sin beneficio en un proceso con un único escritor.
  • Un test lee el código Rust y falla si un código de error no tiene su texto en inglés, o si un texto usa un dato que el backend no manda.

Resultados

  • Con 5.000 proyectos, abrir el tablero pasó de 27 s a 1,4 s y la memoria de 2,9 GB a 372 MB, montando solo las tarjetas que se ven.
  • El escaneo de 5.000 proyectos pasó de 4,5 s a 1,4 s: comparaba cada candidato con todos los ya registrados, y ahora mira solo sus carpetas padre.
  • Más de 300 tests entre Rust y vitest. Versión 0.2.1 para macOS, Windows y Linux, en español e inglés.

Caso de estudio: El Tambor del Juicio

El problema

Un juego de deducción que existe en dos sitios, una terminal en Python y una versión gráfica en Godot, y que tiene que jugar exactamente igual en los dos. Con dos bases de código es fácil que una se desvíe sin que nadie lo note, y la dificultad estaba fijada a ojo.

Cómo funciona

  1. Motor sin interfazLas reglas viven en un módulo sin pantalla ni teclado, así que una partida entera cuesta microsegundos y se puede simular a miles.
  2. Dos interfacesLa terminal usa ANSI, animaciones y teclas. La gráfica está dibujada y sonada por código, sin sprites ni samples de terceros.
  3. SemillaCada partida lleva una semilla. Volver a teclearla reproduce la misma bala, el mismo patrón, las mismas pistas (las mentirosas incluidas) y los mismos eventos.
  4. Banco de balanceUn solver deduce exactamente dónde está la bala y juega miles de partidas por dificultad para medir qué aguanta cada una.
  5. CI y releaseTests, lint y tipos en Python, y Godot en modo headless. Al etiquetar una versión se construyen los ejecutables y se publica la release.

Decisiones técnicas

  • El espacio de estados son solo 32 combinaciones (cuatro patrones por ocho huecos), así que el solver no usa ninguna heurística: tacha las que contradicen lo observado y lo que queda es lo que sabría un jugador perfecto.
  • Un test usa una política rota a propósito para comprobar que el contador de contradicciones salta cuando tiene que saltar: un contador que nunca se dispara no se distingue de uno averiado.
  • Una tabla de paridad compara las reglas de las dos versiones. La semilla reproduce la partida dentro de cada versión, no entre las dos, porque Python y Godot usan generadores distintos.
  • Se mide antes de tocar el balance: el banco mide y no rebalancea, y cualquier cambio de mecánica tiene con qué compararse.

Resultados

  • Con 45.000 partidas simuladas, jugar al azar dura de 1,4 a 2,7 días de media, y deducir bien casi nunca pierde: entre el 83 y el 90 % llega al tope de 300 disparos.
  • Medir el modo duelo destapó un error: el que abría no podía perder. Se corrigió y la regla entró en la tabla de paridad.
  • 99 % de cobertura en Python, tests de lógica y de escena en Godot, y ejecutables para Linux y Windows publicados solos.

Por qué rpmlint no se podía instalar desde el repositorio base

En Azure Linux 4.0, dos paquetes se publicaban en el repositorio base pero no se podían instalar usando solo ese repositorio. Cuento cómo lo detecté y cómo lo arreglé con 8 líneas.

El síntoma

rpmlint y dpkg-perl se publican en rpm-base, pero algunas de sus dependencias de ejecución solo se compilaban para rpm-sdk. dnf repoclosure comprueba justo eso: que todo lo que necesitan los paquetes de un repositorio está dentro de ese mismo repositorio. Contra el base de 4/preview devolvió cuatro dependencias sin resolver.

$ dnf repoclosure --newest
package: dpkg-perl-1.23.5-6.azl4.noarch
  unresolved deps (1):
    perl(Digest::SHA1)
package: rpmlint-2.8.0-5.azl4.noarch
  unresolved deps (3):
    devscripts-checkbashisms
    python3.14dist(pybeam)
    python3.14dist(tomli-w)

La regla que se rompía

El grupo base-packages está documentado como la clausura transitiva de las dependencias de ejecución de sus paquetes. rpmlint se había movido a base en el PR #18393, pero sus dependencias no le siguieron.

Una dependencia que repoclosure no veía

Localicé qué componente aporta cada dependencia: perl-Digest-SHA1, python-pybeam, python-tomli-w y devscripts. Pero pybeam necesita a su vez python-construct, dentro de un rango de versiones concreto. repoclosure solo revisa los paquetes que ya están en el repositorio, y como pybeam no estaba, no podía avisar de lo que él necesita. Por eso son cinco componentes y no cuatro.

El detalle de devscripts

De devscripts solo hace falta el subpaquete pequeño devscripts-checkbashisms. El paquete principal arrastra un árbol grande de perl y dpkg-dev que no debía entrar en base. Así que el componente pasa a base, pero el paquete principal se queda en el SDK mediante exceptions-packages, el mismo patrón que ya usaba ShellCheck.

Cómo lo comprobé

azldev config dump pasa. azldev package list --rpm-file resuelve cada paquete al repositorio esperado: seis paquetes a base y el principal de devscripts al SDK. azldev comp update no cambia ningún bloqueo, porque el canal de publicación no es una entrada del renderizado.

Lo que dejé fuera

repoclosure encontró otro problema en base (rubygem-rdoc-doc), heredado tal cual de Fedora 43. No lo toqué: no era de este arreglo.

Ver el pull request en GitHub

La opción que ya existía y nadie había documentado

Una petición abierta en azldev pedía una forma de que la herramienta nunca deje ficheros de compilación dentro del repositorio git. Resultó que ya se podía: lo que faltaba era explicarlo.

La petición

Cuando un proyecto fija en su configuración los directorios de trabajo y de salida, quien lo usa se queda con ficheros de compilación dentro de su copia de git. Un usuario contaba que construir una imagen dejaba ficheros del usuario root en su árbol, y que para limpiarlos hacía falta sudo git clean.

Primero, comprobar si hacía falta código

La configuración de usuario (~/.config/azldev/config.toml) se carga después de la del proyecto, y su sección [project] puede sobrescribir log-dir, work-dir y output-dir. Es decir, el problema ya estaba resuelto; solo faltaba que alguien lo contara.

Preguntar antes de escribir

Comenté en la petición con el ejemplo y pregunté a los mantenedores si les parecía bien que yo añadiera la documentación, o si querían algo más (por ejemplo, cubrir también rendered-specs-dir y lock-dir).

Lo que escribí

Una sección nueva en la explicación del sistema de configuración, con este ejemplo, y un aviso en la referencia de [project] que enlaza a ella:

[project]
log-dir = "/home/me/azldev/logs"
work-dir = "/home/me/azldev/work"
output-dir = "/home/me/azldev/out"

Los detalles que importan

Las rutas relativas en la configuración de usuario se resuelven respecto a la carpeta de ese fichero, no a la raíz del proyecto, así que lo más claro son rutas absolutas. TOML no expande ~ ni variables de entorno, por lo que hay que escribir la ruta completa. Y pasar --config-file con otra sección [project] sigue teniendo prioridad sobre la configuración de usuario.

Cómo acabó

Quince líneas en dos ficheros de documentación, sin tocar código. Lo aprobó uno de los mantenedores y se fusionó el 23 de octubre.

Ver el pull request en GitHub